自迭代当中的评分函数
本文最后更新于:几秒前
自迭代3要素
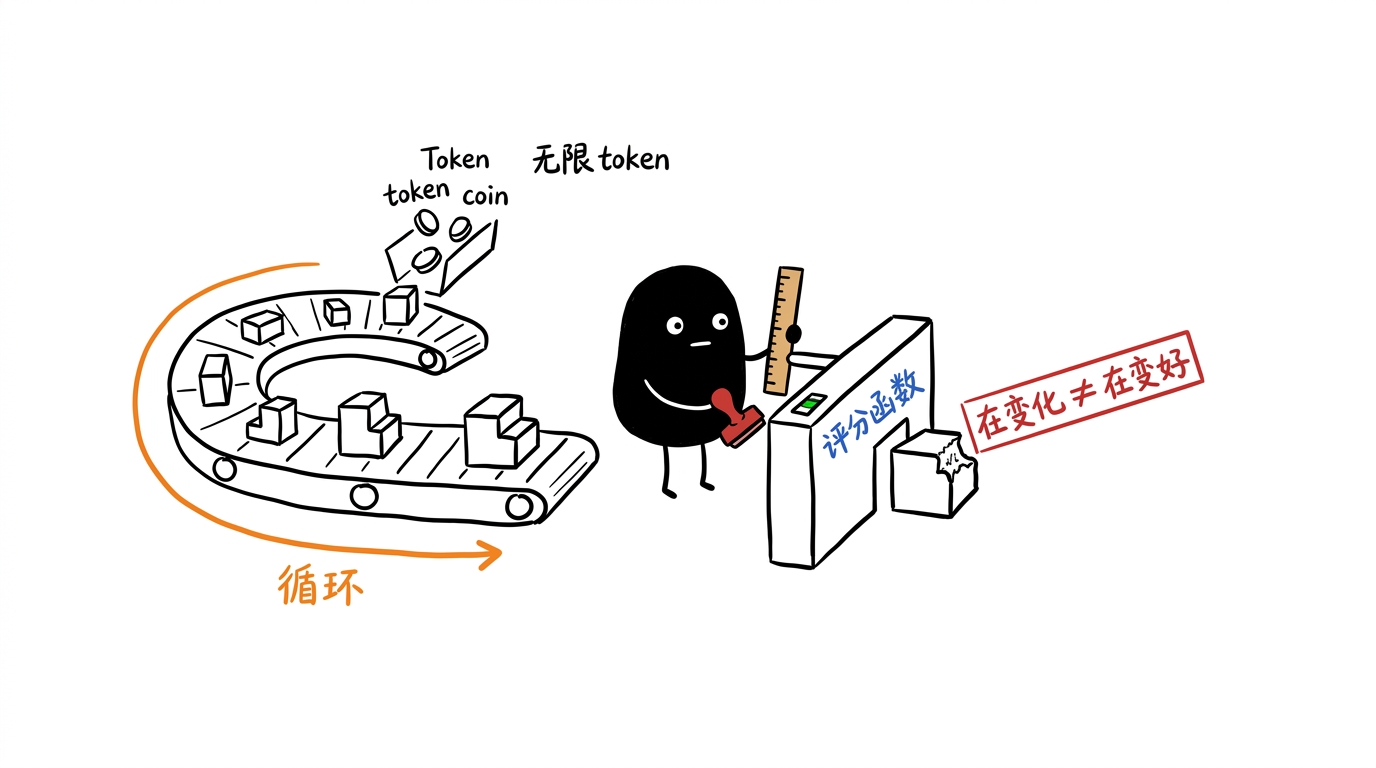
自迭代需要3个必要条件,一个好的循环,一个正确评分函数,以及无限量的 token。
- 循环
- 评分函数
- 无限量的 token
把一个 AI 系统放进循环,给它工具,再提供足够多的 token,它就会持续尝试:生成代码、运行测试、观察结果、修改实现,然后进入下一轮。
这看起来已经很像“自迭代”了。
但这里有一个容易被忽略的问题:
系统一直在变化,不代表系统一直在变好。
并且系统是反映真实世界的虚拟建模,而系统的反馈来自于我们真实世界的反馈。
循环负责让它继续,token 负责让它有资源继续,只有评分函数在回答:这一次变化,究竟值不值得保留?
所以,在这三个要素里面,我认为最值得花时间设计的,不是如何把循环跑得更久,而是如何判断它有没有取得进步。
这里讨论的“自迭代”,主要指 Agent 对代码、提示词、工具配置或工作流的持续改进,并不意味着每轮都在更新模型参数。它改变的可以只是一个函数,也可以是一套完成任务的方法。
关键不在于改了什么,而在于:系统是否能够根据可信的反馈,保留更好的结果,并让反馈影响下一次尝试。
自迭代的评分函数,不能只告诉系统“这个版本看起来更好”,而应该给出一个可以执行的判断:
候选版本相对当前版本,增加了多少已经验证的能力,是否具备替换当前版本的资格。
下面给出一套明确的实现。它的目标不是评价一切,而是解决一个具体问题:
在不违反硬约束、不破坏已有能力的前提下,提高固定任务集的通过率。
为便于直接运行,本文以具有确定性测试的代码改进为例。代码产物可以通过实际运行与测试断言验收,不必依赖模型对自己表现的评价。(Anthropic)
一、先固定评分对象
设当前基线版本为 ,候选版本为 。
准备一组固定任务:
每项任务都必须包含明确的输入、验收条件和权重。第一版可以全部使用相同权重,不必先设计一套复杂的权重体系。
任务是否通过,由测试执行器判断:
由此得到版本的任务通过分:
例如,100 项等权任务通过了 80 项,。
这里的通过分只表示:在这组约定的任务上,已经验收的能力占多少。
它不是模型的综合能力分,也不是用户满意度的替代品。
对于本版函数,速度、成本和代码长度不额外加分。业务确实要求的资源上限,应事先写进验收条件或硬约束。这样就不会出现“因为更快,所以允许结果错误”的补偿关系。
二、把约束与增益写进同一个函数
只有通过率还不够。
候选版本可能修好了几个问题,却破坏了原本正常的功能;也可能输出完全正确,但修改了不允许修改的数据。这些情况不能靠新增通过项抵消。
因此,在计算有效增益之前,定义三个条件。
评价有效:
新旧版本必须使用同一份评价合同,包括任务集、权重、验收器、环境要求和通过门槛。
所有规定的任务与检查项都必须有完整结果,基线也必须已经满足硬约束。
不能通过少跑失败任务、删除结果或更换评分口径来提高分数。
这里还需要区分两种情况:候选代码执行后抛出异常,是已观察到的失败;测试基础设施故障、无法取得结果,则是评价未完成。后者不能被当成通过,也不能悄悄从分母中移除。
硬约束满足:
候选版本必须通过预先规定的强制检查。
例如,在后面的演示中,函数必须返回字符串列表,而且不得修改传入的列表。即使输出内容全部正确,只要修改了输入,仍然不具备替换资格。
硬约束不是扣分项,而是资格条件。
已有能力不退步:
对于基线已经通过的每项任务,候选版本也必须通过:
这项规则明确选择了一种保守策略:允许增加能力,不允许用失去旧能力交换新增通过项。
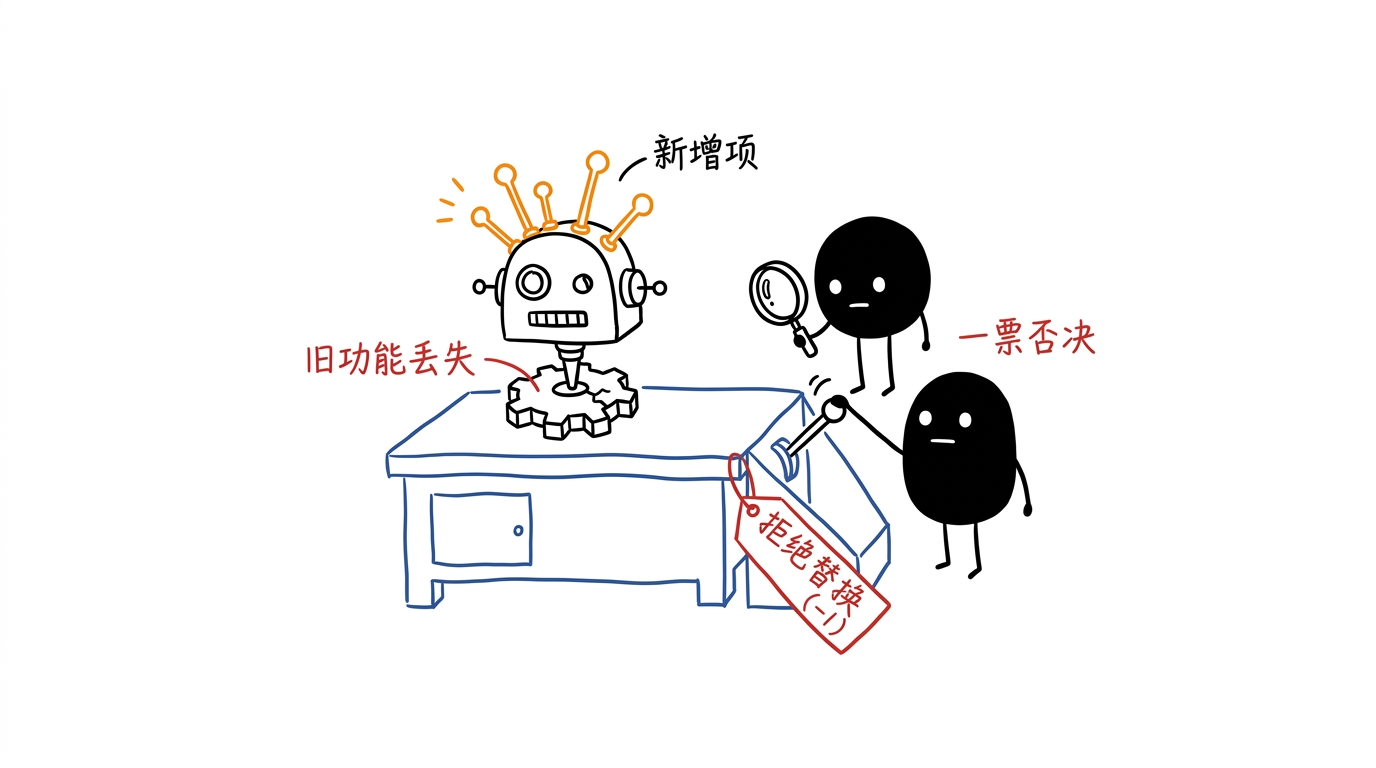
能力评测与回归评测本来就承担不同职责:前者衡量新增能力,后者检查原有能力是否仍然成立。(Anthropic)
将这些条件统一起来,得到最终评分函数:
替换规则也只有一条:
其中, 是提前固定的最小改善门槛。
例如,取 ,表示至少提高 1 个百分点,而不是相对提高 1%。
这个定义没有隐藏的补偿关系:违反约束或出现回归,直接失去资格;满足全部条件,才计算新增收益。
因为有效候选不能丢失任何原有通过项,所以有效评分必定落在 。因此可以用 -1 作为独立的“不具备资格”标记,不会与有效增益混淆。
-1 不是说候选质量为负,而是说它不能参与本次替换。
程序同时返回原因,用 ERROR 表示证据缺失或不可比较,用 REJECT 表示已经确认的约束违反。它们对替换决策都是“不允许”,但并不是同一种事实判断。
三、用真实执行结果检验这套函数
用一个标签标准化函数作为例子。
它的要求是:去掉首尾空白、统一大小写、删除空项和重复项、保留首次出现的顺序,并且不修改输入列表。
例如:
1 | |
演示实现包含 8 项等权测试,基线通过其中 5 项,因此:
下面是演示代码的实际运行结果。每一行都与同一个原始基线比较,不是依次升级后的累计结果。
| 候选版本 | 通过任务 | 硬约束与回归检查 | 最终评分 | 判定 |
|---|---|---|---|---|
| 与基线相同 | 5/8 | 通过 | 0 | 保留基线 |
| 修复空白处理 | 7/8 | 通过 | 25 | 接受 |
| 修复全部已知问题 | 8/8 | 通过 | 37.5 | 接受 |
| 修复部分问题,但错误地排序结果 | 7/8 | 破坏原有顺序测试 | -1 | 拒绝 |
| 输出全部正确,但原地修改输入 | 8/8 | 违反输入不可变约束 | -1 | 拒绝 |
第四行尤其重要。
它的通过率从 62.5% 提升到 87.5%,但一个原本正常的任务退步了。按照本文明确选择的“旧能力不得丢失”策略,它不能被接受。
第五行则说明:即使任务输出全部正确,也不能抵消强制约束的违反。
这不是评分之后再临时补充解释,而是公式本身就会产生的结果。
四、评分数据必须来自执行器
上面的公式能否真正工作,取决于 p_i(x) 和检查结果从哪里来。
本文的实现要求它们由候选版本无权篡改的测试执行器产生,而不是接受 Agent 自己提交的“全部通过”。
优化系统可能找到提高奖励、却没有实现原始目标的方法;评分漏洞不能只靠要求系统诚实来处理。(OpenAI)
因此,一份评价报告至少需要绑定候选版本身份、评价合同身份、完整任务结果、强制检查结果和执行证据。
评价合同还必须包含评分参数。修改任务权重或改善门槛,会生成新的合同标识;旧报告不能直接拿到新合同下继续比较。
需要注意,合同标识解决的是可比性,不是单独解决报告的真实性。报告仍然必须由可信执行器生成,执行证据也必须保存在候选无法改写的位置。
完整实现已附在这里:
代码仅使用 Python 标准库。运行方式:
1 | |
核心调用如下:
1 | |
本次执行中,22 项测试全部通过。其中一项穷举了 4 项任务的新旧通过结果,共 256 组组合,检查评分与替换条件是否一致。
测试还覆盖了缺失任务、未知结果、合同变化、权重变化、硬约束失败和改善门槛的边界。
这里验证的是评分程序的逻辑。演示执行器只运行文件内的可信函数,不是执行任意生成代码的安全沙箱;接入真实 Agent 时,需要由隔离执行环境生成同样结构的评价报告。
五、这套函数承诺什么
这套函数承诺的是:
在同一份有效评价合同下,只有满足硬约束、保留全部原有通过项,并取得足够新增通过收益的候选,才会被接受。
它不会把这个结论扩大成“候选在所有真实场景中都更好”。
反复依据同一批测试结果优化,会让这些测试的信息参与优化过程,不能再把它们当成完全独立的泛化检验。面向新任务的效果,需要另外保留不参与日常修改的验收数据。(Scikit-learn)
本文的可运行版本也明确限定为确定性验收。直接评价随机输出的 Agent 时,单次通过不能被视为稳定能力;需要重复试验,并另外明确成功率与不确定性的接受规则,不能把这里的单次布尔结果原样套用。(Anthropic)
最后,这个版本有意不奖励“通过率相同,但速度更快”的候选,因为它选择的优化目标就是能力增长且无回归。性能优化应当事先定义另一份明确合同,而不是看到结果后临时改变评分标准。
一个真实可用的评分函数,不需要一开始就解释所有维度的“更好”,但必须让目标、公式和接受规则保持一致。
本文的定义可以压缩成一句话:
先确认评价有效、约束满足、旧能力不退步,再用新增通过任务的加权占比计算收益;收益达到门槛,才允许替换。
本博客所有文章除特别声明外,均采用 CC BY-SA 4.0 协议 ,转载请注明出处!